Документальный материал и расчётная методика. Результаты собственного тестирования оборудования не заявляются.
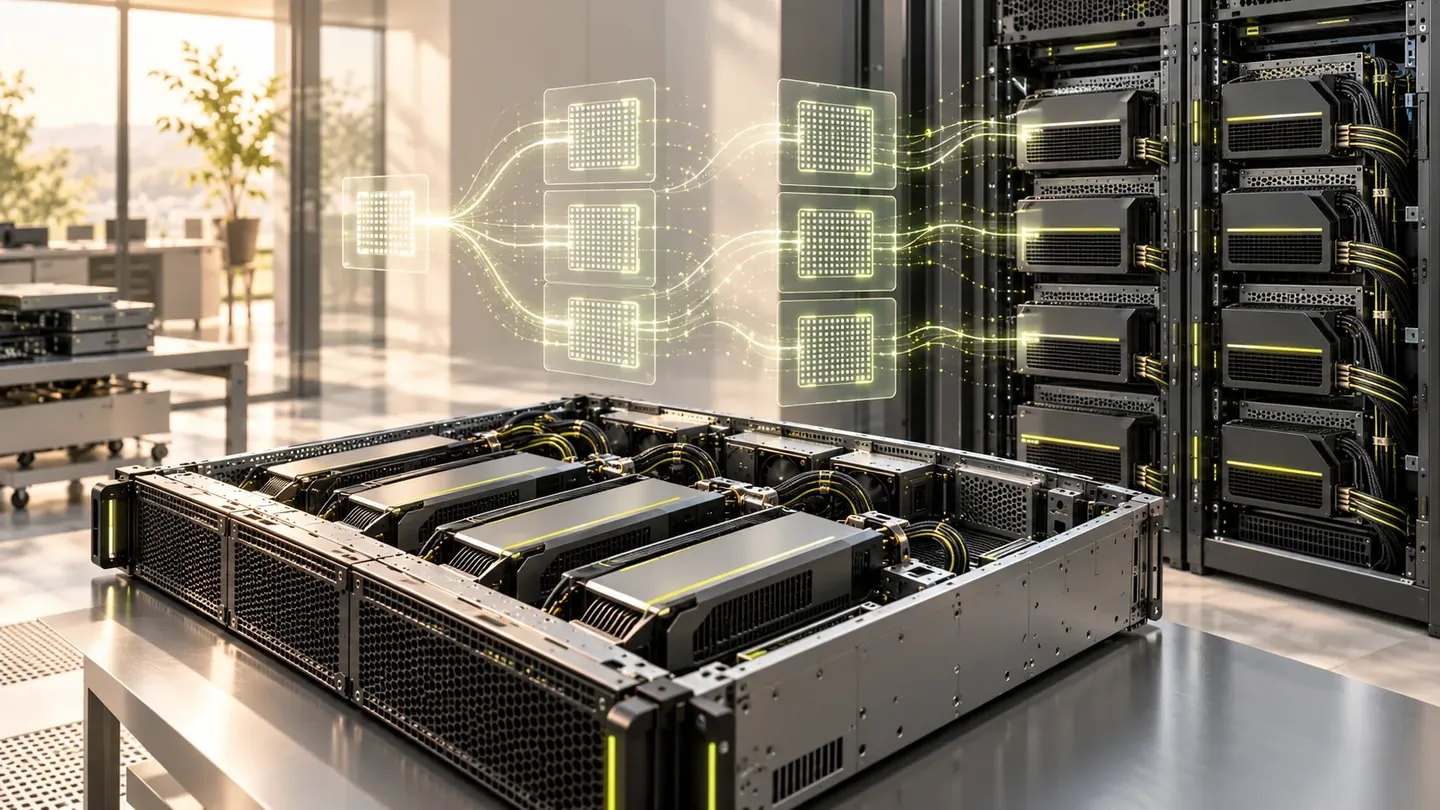
Несколько GPU могут обслуживать независимые копии модели или совместно исполнять одну копию. Во втором случае обмен между устройствами становится частью каждого запроса. Поэтому выбор сети начинается с метода распределения, а не с покупки самого быстрого коммутатора.
Разделите три уровня связи
Первый уровень: GPU внутри одного сервера. Здесь важны разводка PCIe, доступность прямого обмена и специализированные межсоединения, если они предусмотрены. Второй: обмен между серверами. Третий: пользовательская сеть, через которую поступают запросы и возвращаются ответы.
Высокая скорость внешнего Ethernet не исправит неудачную внутреннюю топологию сервера. И наоборот, хороший обмен внутри узла не гарантирует быструю загрузку датасетов из удалённого хранилища. Эти пути измеряют отдельно.
Определите стратегию распределения
Независимые реплики удобно масштабируют поток, если каждая модель помещается на отдельном ресурсе. Tensor parallelism разделяет вычисления модели между устройствами. Pipeline parallelism распределяет слои. Для MoE возможны дополнительные варианты работы с экспертами.
vLLM описывает стратегии параллелизма и отдельно отмечает требования к размещению нескольких GPU и узлов. 1 Наличие функции в движке не гарантирует выгодный результат на любой сети. Схему надо проверить на реальном размере сообщений и нагрузке.
| Сценарий | Основной вопрос |
|---|---|
| Независимые inference-реплики | Как распределяются запросы и хранится модель? |
| Одна модель на нескольких GPU | Какова задержка регулярного обмена? |
| Распределённое обучение | Как синхронизируются состояния и градиенты? |
| Общий датасет | Успевает ли хранилище кормить все узлы? |
Запросите схему топологии
Поставщик должен показать, какие GPU и сетевые адаптеры подключены к каким CPU и PCIe-коммутаторам. Проверьте фактическую ширину линий под полной комплектацией: установка дополнительных устройств может менять доступные ресурсы платформы.
Документация NCCL разбирает прямой обмен, топологию и причины проблем GPU-to-GPU и GPU-to-NIC. 2 Она полезна для диагностики, но не является основанием бездумно отключать защитные настройки системы. Изменения оценивают вместе с администратором и требованиями безопасности.
Измерьте обмен до прикладного теста
Для NVIDIA-окружения проект nccl-tests проверяет корректность и производительность коллективных операций. 3 Сохраните версии и параметры измерения. Результат синтетического обмена помогает найти проблему, но итоговую пригодность подтверждает запуск модели.
После этого измерьте один запрос и поток запросов. Сравните с меньшим числом GPU. Если прирост оказался небольшим, исследуйте вычисления, память, обмен и очередь. Добавлять устройства без понимания узкого места дорого и трудно сопровождать.
Учтите эксплуатацию сети
Для нескольких узлов важны согласованность firmware, драйверов, контейнеров и сетевых настроек. Нужны мониторинг ошибок, документация портов и резервные кабели соответствующего типа. При замене узла необходимо повторить проверку совместимости.
Безопасность тоже зависит от топологии. Служебную коммуникацию распределённого runtime не следует открывать как публичный API. Ограничьте доступ между нужными узлами и документируйте, какие порты действительно используются.
Когда кластер преждевременен
Если модель помещается на одном узле и нагрузка ещё мала, распределённая система может добавить больше расходов, чем пользы. Иногда проще выбрать более ёмкую GPU, несколько независимых реплик или изменить формат модели. Это варианты для сравнения, а не универсальное правило.
В проекте инференса начните с самой простой конфигурации, которая проходит требования. Нагрузочный тест должен показать, когда расширение действительно нужно и какой путь обмена ограничивает рост.
Источники и проверка
- vLLM: Parallelism and Scaling ↗Проверено: 2026-10-23
- NVIDIA NCCL: GPU troubleshooting ↗Проверено: 2026-10-23
- NVIDIA nccl-tests ↗Проверено: 2026-10-23