Документальный материал и расчётная методика. Результаты собственного тестирования оборудования не заявляются.
RAG объединяет поиск по данным с генерацией ответа. Поэтому спецификация одного сервера должна учитывать несколько разных нагрузок. Самая дорогая GPU может простаивать, пока система ждёт извлечения текста из PDF, сетевого хранилища или медленного поиска с фильтрами.
Нарисуйте путь документа и запроса
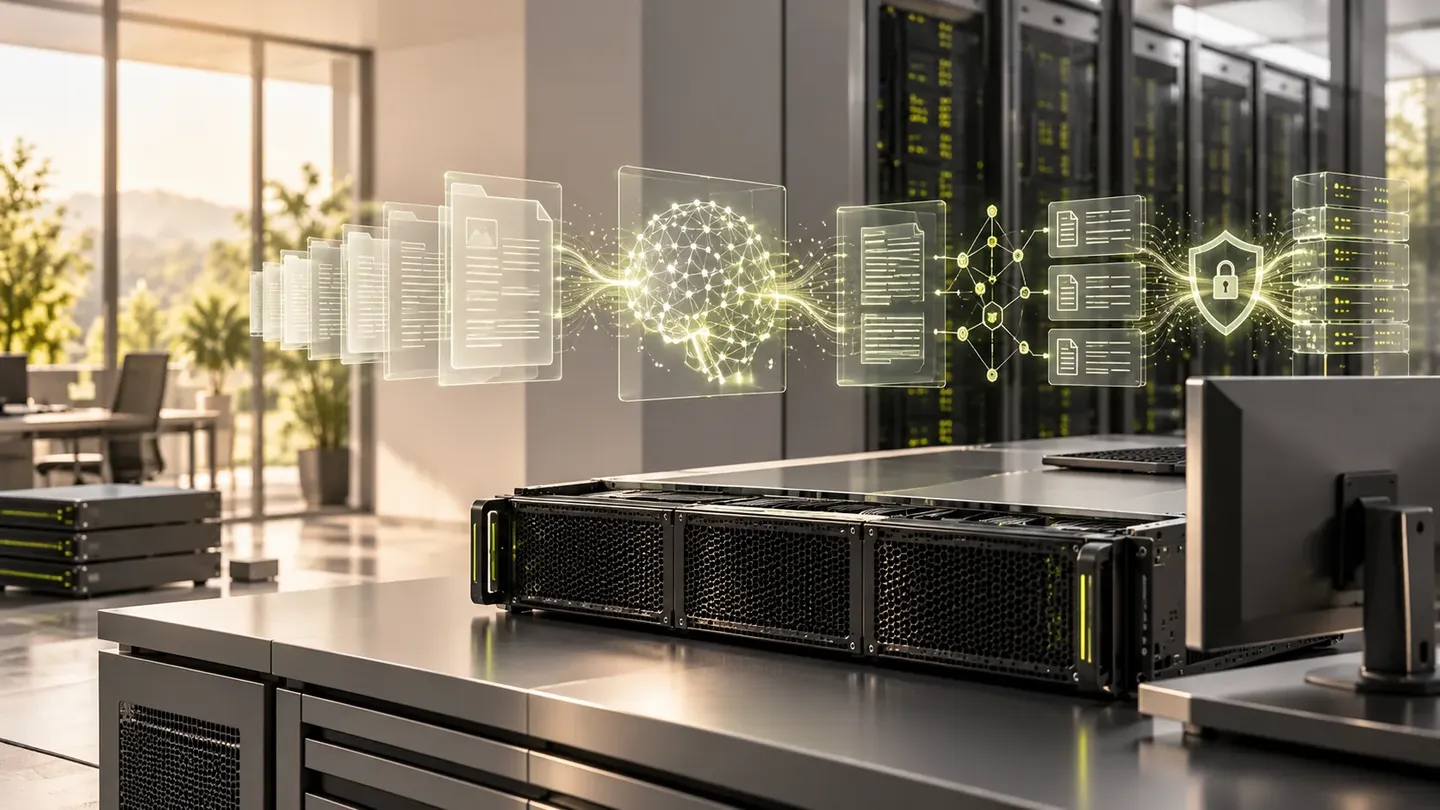
Документ проходит загрузку, извлечение текста, разделение на фрагменты, создание эмбеддингов и запись в индекс. Запрос пользователя проходит авторизацию, поиск, возможное повторное ранжирование, сбор контекста и генерацию. У этих цепочек разные требования к времени выполнения.
Для первого запуска обычно полезно разделить их логически: индексацию выполнять в очереди, а пользовательский запрос обслуживать с ограниченным временем ожидания. Физически всё ещё может работать на одном узле. Это позволяет измерить каждый этап и позже переносить только реальное узкое место.
Считайте индекс отдельно от модели
Если условный миллион фрагментов представлен векторами размерности 1024 в float32, только значения векторов занимают 4 096 000 000 байт, около 3,8 GiB. Это арифметика без графа поиска, payload, служебных структур и копий. Размер исходных документов не даёт такой оценки автоматически: короткие и длинные фрагменты формируют разное число векторов.
Qdrant рекомендует рассчитывать разные векторы и поля payload отдельно, учитывая их размер, тип и индексацию. 1 Поэтому в требованиях надо фиксировать число фрагментов, размерность, тип хранения, фильтры и объём метаданных. Фраза «у нас сто гигабайт документов» описывает лишь часть задачи.
| Компонент | Основной ресурс | Что измерять |
|---|---|---|
| Извлечение и OCR | CPU, иногда отдельный GPU | Страницы в минуту и ошибки |
| Эмбеддинги | CPU/GPU, очередь | Фрагменты в секунду |
| Векторный поиск | RAM, CPU, диск | Задержка с реальными фильтрами |
| Реранкер | CPU/GPU | Качество отбора и время |
| Генератор | VRAM и вычисления | Первый токен, скорость ответа |
Установите бюджет контекста
Количество найденных фрагментов, их длина и история диалога попадают в запрос генератору. Если бесконтрольно увеличивать каждый параметр, вырастут потребление cache и время обработки входа. Ограничение должно следовать из оценки качества: какие фрагменты действительно нужны для ответа, а какие только добавляют шум.
Практический эксперимент: сравните небольшое, среднее и большое число фрагментов на одних вопросах. Оцените полноту ответа, корректность ссылок и задержку. Выбирать максимальный контекст только потому, что он поддерживается моделью, экономически не обязательно.
Права доступа проверяются до генерации
Если сотрудник не вправе читать документ, его фрагмент не должен попасть в контекст. Скрыть ссылку после генерации недостаточно: содержимое уже использовано. Определите, где хранится принадлежность документа, как обновляются права и что происходит при удалении источника. Документация Qdrant описывает фильтрацию по payload как механизм отбора, но бизнес-правила доступа проектируются отдельно. 2
Проверьте отрицательные сценарии: одинаковые вопросы пользователей с разными правами, удалённый документ, потерянная группа, старый индекс, ошибка синхронизации. Такой тест часто важнее демонстрации красивого ответа на общедоступную инструкцию.
Критерии пилота
Соберите обезличенный набор вопросов с эталонными источниками. Включите вопросы без ответа в базе, противоречащие документы, длинные таблицы и запросы с ограниченным доступом. Измеряйте поиск и генерацию раздельно. Если нужный документ не найден, увеличение модели не исправляет первичную ошибку.
Для спецификации понадобятся схема данных, число фрагментов, частота обновлений, профиль запросов и допустимые задержки. Обсудите RAG-инфраструктуру после такого описания: тогда подбор GPU, RAM и накопителей можно обосновать нагрузкой. Материал о дисках для AI поможет отдельно проверить загрузку индекса и резервное восстановление.
Источники и проверка
- Qdrant: Capacity Planning ↗Проверено: 2026-10-23
- Qdrant: Filtering ↗Проверено: 2026-10-23